Николай, на косинусной близости. Евклидово расстояние не годится, хотя кто-то из умных (Дэн Петрович, кажется) утверждал, что в Гугл используется именно евклидово расстояние с нормализацией. Они по сути эквивалентны, так что разница невелика.
Звучит всё это страшно и многих пугает, но вам любая иишная балалайка скрипт накидает за 5 минут - проблема в основном в выборе модели для извлечения векторных вложений (они же - эмбеддинги). Вот у вас матрица текста (или его фрагмента), вот - матрица запроса. Остаётся прогнать через скрипт, чтобы обнаружить близость в векторном пространстве (примерно как это делают и поисковые семантические алгоритмы, и ИИ-системы).
Результат, разумеется, очень приблизительный, и даёт только поверхностное представление, но с этим уже можно работать.
Нечто подобное уже вшито в Screaming Frog последних версий. Подключаете какую-то модель вложения (хоть платную по API, хоть бесплатную с локального сервера) - и во время сканирования модель формирует вам вложения. После этого там же можно задать запрос (хоть короткий, хоть длинный) и посмотреть, какие именно страницы наиболее близки по векторам к этому запросу. После этого думать, что делать.
А можно просто выгрузить контент и делать это локально с помощью NLP-пайплайна типа Bertopic. Сайт размером в 20-30 тысяч страниц при обработке займёт до получаса времени (в зависимости от выбранной модели и ресурсов сервера).
Разумеется, полученные запросы после всего лучше группировать, чтобы однородное размещать на одной посадке, а несклеиваемое не пытаться усадить на одну страницу.
Пороги показателей релевантности также надо вычислять методом научного тыка: BERT в среднем считают при пороге в 0,6 как релевантный (для шинглов). Как по мне - этого сильно мало, я сейчас поднял для себя до 0,8 (при пороге в 1 - полное совпадение, чего в жизни не бывает).
Ещё лучше таким способом вылавливать дубли по смыслу (рерайты, грубо говоря). В общем, зависит от пайплайна, модели и ещё пачки факторов. Но если куда копать сейчас - то я предпочитаю это направление, результаты мне нравятся.
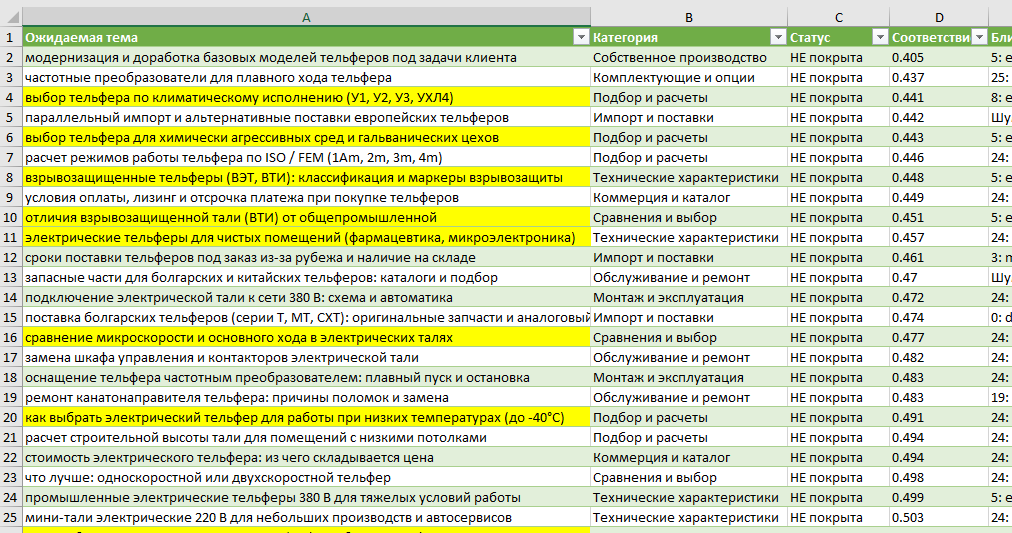
Приведу пример дока (вчера ответ второпях писал).
Суть: выгружаем контент сайта (всего или конкретного раздела). Векторизуем. Готовим список запросов, которые важны для целевой аудитории и ИИ-систем (к которым будет обращаться целевая аудитория). Сопоставляем, выясняем, что там ИИ видит на эту тему по сайту и насколько это вообще хорошо. Колонка "Соответствие" в табличке - это как раз математический показатель. Нижний порог тут определен в 0,8. Оцениваем результат (вывод в табличку). Можно сопоставить с другими данными (скажем, просто опросить продажников - насколько с их точки зрения вопрос весом).
Готовим соответствующий контент в том формате, что требуется (коммерческая страничка, статья, обзор, страница в справочнике). Оцениваем результаты.
Запросы, разумеется, чаще всего "длиннохвостые", в системы статистики такое не попадает, поэтому важно не наклепать контента, у которого попросту нет спроса и его не понимают поисковые системы, поэтому при подготовке списка стоит использовать такие инструменты, как ИИ-модели, используемые на поиске, PAA, данные Метрики, темы из посещаемых страниц конкурентов и т.п.
ProgerMir, можно и так, но плюсов сильное меньше.
а) Каноническая страница самостоятельна, и в нынешних условиях ждать, что Гугл догадается (когда-нибудь) все эти страницы консолидировать можно очень долго - и не дождаться.
б) Для Яндекс это не лучшая практика по той же причине. Вероятнее всего, он будет бесконечно переклеивать целевую страницу - там же в принципе почти одно и то же.
в) Сами по себе страницы пагинации в поиске шансов имеют слишком мало. Тот же Гугл может оценить их в духе "найдено, не просканировано" и т.п.
Видел кейсы, где на пагинацию вешались какие-то вспомогательные ключевики (те же топонимы в тайтл). В общем, тут есть поле для экспериментов, я чаще всего их просто склеиваю.
Михаил Р., грешу на браузерные расширения, видимо, другой причины нет. А там стафф-то старый, полезный, ничего лишнего.
Проблема явно не общая, иначе я бы в "Инкогнито" получал всё ту же ошибку.
ImagineTables, основной месседж - да никак. Не только тракеры как таковые - угроза анонимности. Я уже упоминал выше слив Яндекса. Там упомянута их система "Крипта". Система собирает данные о пользователе из почти сотни сервисов Яндекса. Поисковые логи туда входят. Их не заблокировать.
Эти данные доступны как рекламным системам Яндекса, так и его партнёрам.
uBO работает в браузере, поэтому ничего с этим не поделать - кроме чисток истории, куки, ничего не искать в своей учётной записи, прятаться за ВПН - в общем, максимально затруднить идентификацию своего профиля самими поисковиками.
Всё прочее - это про настройки uBlock. Для примера: сайт СМИ вполне мог маскировать тракеры под свои локальные ресурсы (CNAME cloacking). Скрипты с самого домена uBO по умолчанию не блокирует.
Михаил Р., да, там те же принципы, что и с профилями для накрутки ПФ. В сливе Яндекса (2022?) на эту тему много любопытного было. Типа метки бота на неделю с сопутствующими проблемами и всё такое.
shurshur, так это норма для любого развитого рынка. Есть масс-маркет - стандартный, дешёвый, по сути безликий. Есть премиум-сегмент со своими отличиями у каждого и плохо классифицируемый по этой причине.
Лучше маленькая пицца, чем крохи от большой.
Я, к примеру, потенциальному клиенту чётко определяю, чем занимаюсь, а чем нет. Ассортимент услуг выходит сильно меньший в сравнении с какой-нибудь студией или агентством, которые берутся сразу за всё - но по верхам. Не могу сказать, что не хватает клиентуры, или что приходится делать то, что меня персонально не радует.
Сергей Горностаев, а это неизбежно.
Принципы копроэкономики добрались и до IT. Фишка в том, что бренды (как нечто незыблемое) и качественный продукт, сделанный всерьёз, не нужны. Важно "тяп-ляп - и в продакшн", пока не протухло и есть какой-то вероятный спрос.
Вариантов-то не много. Хитрить, выжигая токены для учётности, или реально оптимизировать пайплайн, находя реальное применение агентам (хотя и не всегда нужное). Определять, что можно скинуть на "железяк", а что - нет.
Надо понимать, что руководство эти нюансы тоже учитывает, и их устраивают правила игры.
Ну, пусть.
CuriousFish, кхе.
Ровно та же проблема коснулась копирайтеров, журналистов, аналитиков, дизайнеров, фотографов, специалистов по видео, маркетологов. Уже цепляет адвокатов, врачей - и список можно продолжать.
Не вижу смысла бодаться с паровозом - он, как минимум, сильнее. Ключевое слово тут - адаптация.
Никакой "ИИ" не заменит специалиста с его опытом, мозгами, "контекстом". Это всё про шаблонизацию.
Да, у многих владельцев бизнеса и руководителей башенку на теме внедрения "передовых технологий" снесло. Очухаются. та самая "незримая рука рынка" порешает, хотя как раньше, конечно, уже не будет.
Вам я бы просто посоветовал не спеша обдумать свои рабочие процессы, общую стратегию, понять, как всё это добро (и на каких объёмах) внедрять. И пользоваться.
В хорошем случае это очень сильный инструмент - но только инструмент, не замена человеку уж никак.
ProgerMir, технически - да. Если страница рекомендацией владельца сайта исключается из индекса, то вероятность того, что краулер каким-то образом перейдёт на каноническую исчезающе мала.
Другое дело, что есть всё же разница между сканированием и индексированием - для Гугл как минимум. Мета "robots" со значением "noindex, follow" буквально означает, что вносить этот контент в индекс не надо, но по ссылкам переходить стоит. Робот всё же может сканировать контент и идти куда-то ещё. Но рассчитывать, что это произойдёт, едва ли стоит - поисковые системы и так дичайше экономят свои ресурсы, и страничка в noindex просто выпадает. Вот поэтому я в ноиндекс страницы пагинации не закрываю никогда.
В целом же надо смотреть конкретно на проект. Если нет проблем с ранжированием целевой посадочной страницы с переклейкой запросов на страницы пагинации - пусть они будут открыты для сканирования и индексирования. Задача - поисковая система должна консолидировать весь этот ворох воедино и понимать, что страницы пагинации - вспомогательные для целевой, канонической. Вот если не понимает - надо разбирать, почему, и искать решения.
Последний раз проблемы с пагинацией я видел довольно давно. Первая - дичайше переспамленная целевая. Вторая - робот тратит весь бюджет на сканирование в пользу пагинации, хотя там ничего хорошего, в общем-то, нет.
MelkijTim, не думаю, что проблема в аффилированности. Склеенные сайты обычно выносятся из индекса наглухо.
То, что вебмастер отдаёт контент при проверке - мало что значит. Тут надо смотреть именно логи, притом за период - прежде всего на размер полученных ботом данных. Если разница существенная - вполне вероятно, что речь как раз про софт 404. Банально: робот регулярно заходит ночью, а у хостера там какие-нибудь сервисные работы, и робот получает примерно ничего.
Вылет за топ-100 для нормальной главной страницы - это 100% про фильтр, а вот какой - надо думать. Версию с тайтлами я бы сразу отбросил, это мало влияющий на что-то фактор. Ну и за артикулы совпадающие никто выкидывать не станет.
Остаётся либо техничка, либо выпадающая из шаблона структура страницы - в том числе и по ключам BM25. Сопоставляйте с топ-10-15.
Если бы сайт из топов отъехал в топ-30 - можно было бы понять, Яша делает это в том числе и потому, что не любит застойность выдачи и топы иногда перетряхивает рандомно. Но тут что-то другое.
Как вариант - оцените ПФ хоть по Метрике или Вебмастеру. Результативного склика я давно не видел, но на больших объёмах и за долгое время эту вероятность я бы всё же рассмотрел.
Ziptar, если я к мыльному цифровому фото с пиксельными шумами добавлю пленочное зерно - это дорисовка, тем более от балды? Если к сизой цифровой гамме применю пленочный цветовой профиль?
Картинка визуально будет много приятнее - и без всяких дорисовок.
Adamos, не соглашусь.
Вот у нас фотка маленького разрешения, сделанная на допотопную цифровую мыльницу. Пиксельные гнусные шумы, сбитый баланс белого, малый динамический диапазон. Это всё правится.
Шедевр не выйдет, но замаскировать что-то, выправить проблемное - вполне вариант.
Ну и что касается деталей. У Маргулиса есть "метод марсианина", основанный именно на добавлении отсутствующих деталей вне акцента (цветовых, тональных) - вполне себе реальный улучшайзер (хотя и не для всего). Почему б нет? Чистая психофизика, как с теми же шумами. Цифровые смотрятся плохо. Подмешиваем "аналоговые" - другой коленкор, хотя зритель даже не всегда понимает, что изменилось.
Ror21e41, просто обычная история. Смотришь в логи - и видишь, как гуглобот ползает по давно убитым урлам спустя годы после правильно выполненной реструктуризации.
Индекс-то не один, их много. Тут матрица обратных, тут скачанные странички, тут данные по ссылкам, полезным сигналам, там - список шинглов, которые Гугл счёл хорошими. И вот структура убивается, а эти обломки по разным индексам остаются.
Гуглоиды официально признавали, что 301 редиректы окончательно переклеиваются за срок чуть не в полтора года. Это, конечно, в большей мере доменов касалось, но очень уж похоже на правду и относительно страниц. А ресурсов на обходы они выделяют с каждым годом всё меньше - и незачем тратить эти их бюджеты на обход давно мёртвых адресов, не говоря уже про риски разных глюков.
JDJ, "знание" - это не совсем то, что можно получить в готовом виде. Это не прочитанная или услышанная информация. Это процесс извлечения множества данных из множества источников, их фильтрации, оценки, взвешивания, суммаризации и формирования выводов на этой основе.
Даже "высшее образование" - это только способ обучения обучению, формирование правильных структур, нейронных связей, методов и т.п.
И собственно знание - это примерно то, что останется в голове после амнезии в результате удара лопатой плашмя. Это вшито в кости, а амнезия - всего лишь сброс кэшей.
Combinator_30, ну вот я думаю, что тут индустрия очень сильно разделится. С одной стороны - суперкомпьютеры для супермоделей, затратные и закрытые. С другой - SLM, заточенные под агентские задачки, дешёвые и доступные массам.
То, что происходит в этой нише сейчас - какой-то шабаш и промискуитет. А выхлоп - очередные умные колонки и очки. Ну, и плюс генерация слопа на дичайших объёмах.
Combinator_30, тут два момента. NLP и зависимость от контекста. Если бы модель выдёргивала единственные верные решения (или максимально близкие, там скоринг простой) - никаких проблем. Вопросно-ответные системы примерно так и работают.
А вот второй момент - экономическая целесообразность и целесообразность вообще. LLM не задуманы как эксперты, владеющие истиной в последней инстанции. Речь всего лишь об устойчиво воспроизводимых речевых паттернах, имитирующих мышление. Зачем усложнять процесс?


Звучит всё это страшно и многих пугает, но вам любая иишная балалайка скрипт накидает за 5 минут - проблема в основном в выборе модели для извлечения векторных вложений (они же - эмбеддинги). Вот у вас матрица текста (или его фрагмента), вот - матрица запроса. Остаётся прогнать через скрипт, чтобы обнаружить близость в векторном пространстве (примерно как это делают и поисковые семантические алгоритмы, и ИИ-системы).
Результат, разумеется, очень приблизительный, и даёт только поверхностное представление, но с этим уже можно работать.
Нечто подобное уже вшито в Screaming Frog последних версий. Подключаете какую-то модель вложения (хоть платную по API, хоть бесплатную с локального сервера) - и во время сканирования модель формирует вам вложения. После этого там же можно задать запрос (хоть короткий, хоть длинный) и посмотреть, какие именно страницы наиболее близки по векторам к этому запросу. После этого думать, что делать.
А можно просто выгрузить контент и делать это локально с помощью NLP-пайплайна типа Bertopic. Сайт размером в 20-30 тысяч страниц при обработке займёт до получаса времени (в зависимости от выбранной модели и ресурсов сервера).
Разумеется, полученные запросы после всего лучше группировать, чтобы однородное размещать на одной посадке, а несклеиваемое не пытаться усадить на одну страницу.
Пороги показателей релевантности также надо вычислять методом научного тыка: BERT в среднем считают при пороге в 0,6 как релевантный (для шинглов). Как по мне - этого сильно мало, я сейчас поднял для себя до 0,8 (при пороге в 1 - полное совпадение, чего в жизни не бывает).
Ещё лучше таким способом вылавливать дубли по смыслу (рерайты, грубо говоря). В общем, зависит от пайплайна, модели и ещё пачки факторов. Но если куда копать сейчас - то я предпочитаю это направление, результаты мне нравятся.