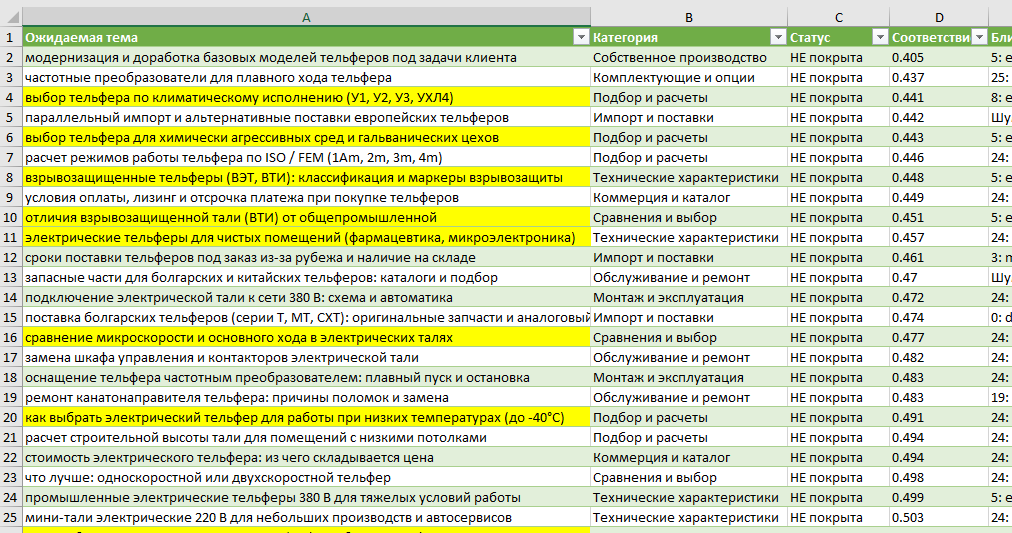
Вычисляйте, каким запросам (интентам, не ключам) нужен соответствующий контент на сайте. Добавляйте.
"Вордстат" - не помощь. Либо NLP, либо (и лучше) - отдел продаж.
Всё прочее - от лукавого.
Приведу пример дока (вчера ответ второпях писал).
Суть: выгружаем контент сайта (всего или конкретного раздела). Векторизуем. Готовим список запросов, которые важны для целевой аудитории и ИИ-систем (к которым будет обращаться целевая аудитория). Сопоставляем, выясняем, что там ИИ видит на эту тему по сайту и насколько это вообще хорошо. Колонка "Соответствие" в табличке - это как раз математический показатель. Нижний порог тут определен в 0,8. Оцениваем результат (вывод в табличку). Можно сопоставить с другими данными (скажем, просто опросить продажников - насколько с их точки зрения вопрос весом).
Готовим соответствующий контент в том формате, что требуется (коммерческая страничка, статья, обзор, страница в справочнике). Оцениваем результаты.
Запросы, разумеется, чаще всего "длиннохвостые", в системы статистики такое не попадает, поэтому важно не наклепать контента, у которого попросту нет спроса и его не понимают поисковые системы, поэтому при подготовке списка стоит использовать такие инструменты, как ИИ-модели, используемые на поиске, PAA, данные Метрики, темы из посещаемых страниц конкурентов и т.п.
Николай, на косинусной близости. Евклидово расстояние не годится, хотя кто-то из умных (Дэн Петрович, кажется) утверждал, что в Гугл используется именно евклидово расстояние с нормализацией. Они по сути эквивалентны, так что разница невелика.
Звучит всё это страшно и многих пугает, но вам любая иишная балалайка скрипт накидает за 5 минут - проблема в основном в выборе модели для извлечения векторных вложений (они же - эмбеддинги). Вот у вас матрица текста (или его фрагмента), вот - матрица запроса. Остаётся прогнать через скрипт, чтобы обнаружить близость в векторном пространстве (примерно как это делают и поисковые семантические алгоритмы, и ИИ-системы).
Результат, разумеется, очень приблизительный, и даёт только поверхностное представление, но с этим уже можно работать.
Нечто подобное уже вшито в Screaming Frog последних версий. Подключаете какую-то модель вложения (хоть платную по API, хоть бесплатную с локального сервера) - и во время сканирования модель формирует вам вложения. После этого там же можно задать запрос (хоть короткий, хоть длинный) и посмотреть, какие именно страницы наиболее близки по векторам к этому запросу. После этого думать, что делать.
А можно просто выгрузить контент и делать это локально с помощью NLP-пайплайна типа Bertopic. Сайт размером в 20-30 тысяч страниц при обработке займёт до получаса времени (в зависимости от выбранной модели и ресурсов сервера).
Разумеется, полученные запросы после всего лучше группировать, чтобы однородное размещать на одной посадке, а несклеиваемое не пытаться усадить на одну страницу.
Пороги показателей релевантности также надо вычислять методом научного тыка: BERT в среднем считают при пороге в 0,6 как релевантный (для шинглов). Как по мне - этого сильно мало, я сейчас поднял для себя до 0,8 (при пороге в 1 - полное совпадение, чего в жизни не бывает).
Ещё лучше таким способом вылавливать дубли по смыслу (рерайты, грубо говоря). В общем, зависит от пайплайна, модели и ещё пачки факторов. Но если куда копать сейчас - то я предпочитаю это направление, результаты мне нравятся.